Durante la sesión What's new in Copilot Studio de Microsoft Ignite 2026, Jason Moore —vicepresidente de producto de Copilot Studio— lanzó una afirmación que hace apenas dos años habría sonado a ciencia ficción y que, sin embargo, casi nadie en el auditorio cuestionó:
«La nueva versión de Copilot Studio que lanzamos en agosto está construida íntegramente por agentes. La versión actual de Copilot Studio no tiene nada que haya sido tocado a mano.»
No era una metáfora. Moore explicó que el papel de los ingenieros humanos en el equipo ha cambiado de capa: ya no escriben el producto línea por línea, sino que construyen agentes que construyen agentes, los cuales a su vez construyen Copilot Studio —o crean nuevos agentes especializados para hacerlo—. Es una señal inequívoca del momento que atraviesa la ingeniería de software: cada vez tecleamos menos código a mano y, paradójicamente, producimos más software que nunca.
Pero esa es solo la mitad de la historia. En el tramo final de la misma sesión, Moore dejó caer la otra cara de la moneda, mucho más relevante para cualquiera que esté llevando agentes de Power Platform a producción:
«Lo número uno que distingue a un buen agente de un mal agente es construir evaluaciones.»
Si el código y las configuraciones iniciales ya pueden delegarse en agentes, el cuello de botella deja de estar en la construcción. Se desplaza a saber definir qué significa que un agente funcione bien, medirlo de forma sistemática y gobernarlo cuando llega a manos de los usuarios reales. Ahí es donde hoy se necesitan de verdad las habilidades de ingeniería.
De artesanos del steering a la software factory
Para entender por qué Microsoft decidió reconstruir Copilot Studio desde cero con este enfoque, conviene mirar el dato de velocidad que abrió la charla: hace un año, un laboratorio puntero lanzaba un nuevo modelo de lenguaje frontier cada 17 días; hoy, entre los aproximadamente ocho grandes laboratorios del sector, aparece uno nuevo cada 6 días. Solo en los siete días previos a Ignite 2026 se publicaron cinco modelos principales.
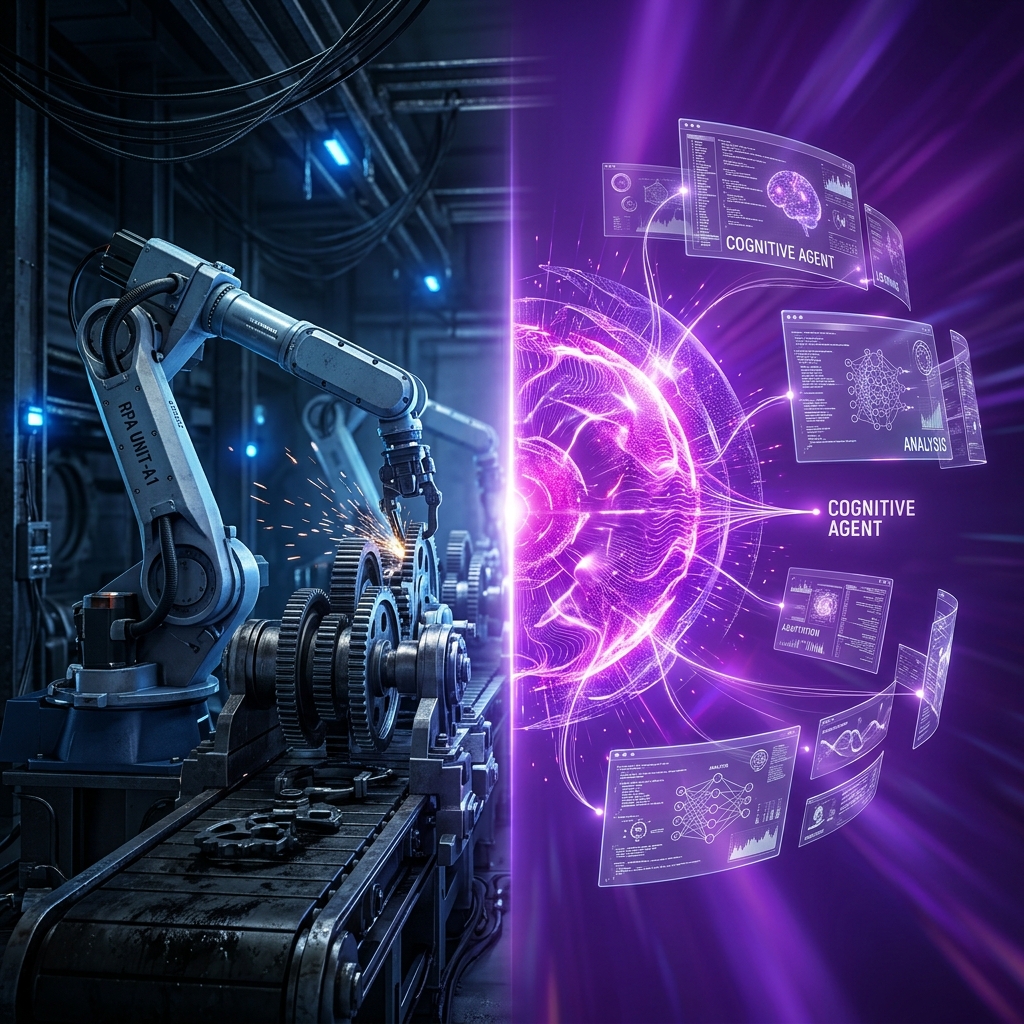
En la presentación, Moore resumió este salto con dos imágenes muy elocuentes: primero, una fotografía en blanco y negro de artesanos trabajando el cuero a mano; después, una cadena robotizada de ensamblaje automotriz. En la era de GPT-3.5 y GPT-4o, construir soluciones de IA era un trabajo artesanal basado en el steering: enviar una instrucción, revisar la respuesta, corregir el rumbo y repetir paso a paso. El antiguo Copilot Studio —lo que Microsoft llama ahora el Standard harness— estaba repleto de código diseñado precisamente para mantener a modelos menos capaces dentro de los raíles.
Los modelos actuales razonan durante horizontes largos, planifican, ejecutan herramientas y se recuperan cuando una API devuelve un error. Ese cambio habilita el modelo de software factory (fábrica de software), un concepto que ha dominado el debate técnico durante todo 2026.
Qué dice la industria sobre las software factories (y sus riesgos)
Lo ocurrido en Copilot Studio no es un caso aislado ni un simple titular de escenario. En febrero de 2026, el equipo de IA de StrongDM desató una intensa conversación en la comunidad de ingeniería —recogida por Simon Willison y analizada incluso desde programas académicos como Stanford CodeX— al publicar cómo operaban su propia Dark Factory bajo dos reglas radicales: ningún humano escribe código y ningún humano revisa código. Los ingenieros pasan a definir especificaciones claras, escenarios de prueba ocultos (holdout scenarios) y gemelos digitales de servicios externos contra los que los agentes iteran hasta converger.
Al mismo tiempo, voces pragmáticas del sector y estudios como el informe tecnológico de Bain & Company de 2026 advierten sobre la otra cara de este paradigma:
- El riesgo de la entropía y el code slop: sin fronteras arquitectónicas firmes ni pruebas deterministas, los agentes amplifican la ambigüedad y pueden generar deuda técnica a velocidad industrial.
- La inversión de la responsabilidad: cuando el código no pasa por ojos humanos y solo se valida su comportamiento externo, el cumplimiento normativo, la auditoría de seguridad y el diagnóstico de fallos sistémicos exigen controles mucho más estrictos que antes.
- El cambio de perfil profesional: el ingeniero senior no desaparece; evoluciona hacia un rol de arquitecto de sistemas, guardián del contexto y diseñador de las señales de verificación que impiden que la fábrica produzca basura.
Qué cambia realmente en Copilot Studio bajo el capó
Más allá del titular sobre cómo se programó la herramienta, la sesión dejó claro dónde posiciona Microsoft a Copilot Studio dentro de su ecosistema: Microsoft 365 Copilot y Cowork cubren la productividad individual del empleado; GitHub Copilot se orienta a crear productos y servicios desde cero; y Copilot Studio ocupa el espacio central de la innovación en procesos de negocio.
Para resolver procesos completos, la plataforma renovada integra de forma nativa tres pilares en un mismo entorno: Agentes (para razonar y tomar decisiones abiertas), Workflows rediseñados y más rápidos (para lógica determinista, económica y predecible, con posibilidad de incluir nodos de modelos o aprobaciones humanas) y Apps —ya en disponibilidad general (GA)— para ofrecer visualización, mando y control al usuario final. Además, todo ello puede crearse o migrarse de forma agéntica en lenguaje natural mediante el servidor MCP de Copilot Studio desde Cowork, GitHub Copilot, Claude Code u OpenAI Codex.
El Microsoft Copilot Harness: el mismo modelo, resultados radicalmente distintos
Una de las lecciones más importantes del año en ingeniería agéntica es que un agente no es solo el LLM que eliges en el desplegable: es el modelo más su harness (el entorno de ejecución, orquestación, gestión de contexto, herramientas y bucle de recuperación). Microsoft presentó en disponibilidad general el nuevo Microsoft Copilot Harness —compartido con Foundry y Cowork— junto a otros dos entornos según el escenario: el Customer Conversation Harness (lanzado en octubre para chat web y voz de baja latencia en atención al cliente) y el Standard Harness para mantener compatibilidad con agentes clásicos.
Los datos internos compartidos por Jason Moore en Ignite 2026 son contundentes. Microsoft ejecutó entre 50.000 y 60.000 pruebas de aceptación usando exactamente el mismo modelo (Claude Sonnet 4.6) y las mismas tareas, cambiando únicamente del Standard harness clásico al nuevo Microsoft Copilot Harness:
- Calidad de conocimiento (Knowledge): pasa del 66,0 % al 86,4 % (+20,4 puntos).
- Análisis de código (Code analysis): salta del 40,6 % al 88,1 % (+47,5 puntos).
- Análisis de archivos (File analysis): sube del 63,5 % al 91,7 % (+28,2 puntos).
- Uso multiherramienta (Multi-tool): mejora del 87,0 % al 98,8 % (+11,8 puntos).
- Consumo medio de tokens de entrada: baja de 47,8K a 26,5K por conversación (-45 %).
Ese último dato es especialmente relevante para equipos de arquitectura y FinOps: los tokens de entrada son el principal factor de coste en la IA empresarial actual. Un mejor harness no solo dispara la precisión en análisis de archivos y código, sino que reduce casi a la mitad el coste por conversación sin tocar el modelo subyacente.
A esto se suman otras capacidades clave presentadas en la sesión que refuerzan la madurez operativa de la plataforma: un catálogo corporativo de Skills (archivos skills.md gobernados por TI y reutilizables entre agentes), Memoria de agente (que recuerda preferencias del usuario y aprende qué secuencias de herramientas resultan más eficaces, abaratando la ejecución con el paso de las semanas), Auto Model Selection en Preview (para seleccionar automáticamente el modelo más económico que cumpla el umbral de inteligencia y cumplimiento corporativo sin sufrir la fatiga de evaluar lanzamientos cada seis días) y MCP Apps para renderizar widgets interactivos directamente dentro del chat.
Por qué las evaluaciones son la verdadera ingeniería de agentes
El dato de adopción interna que dio Moore explica por qué la gobernanza y las pruebas han pasado de ser un complemento a convertirse en el centro de la arquitectura: Microsoft pensaba inicialmente que en la compañía habría tantos agentes como aplicaciones internas o empleados (alrededor de 250.000), pero ya supera ampliamente el millón de agentes ejecutándose cada día en Microsoft.
A esa escala, el enfoque habitual de los primeros pilotos —lo que la industria llama vibe-checking: hacer cinco preguntas a mano en el panel de pruebas, ver que responde bien y publicar— se rompe por completo. Un cambio menor en las instrucciones del sistema, una actualización de un servidor MCP o un relevo de modelo pueden introducir regresiones silenciosas que solo salen a la luz cuando un cliente o un empleado se encuentra con un error grave.
En la diapositiva dedicada a Evaluate before you publish (GA), Microsoft resume bien este giro: los equipos no podían demostrar con evidencias que un agente estaba listo antes de publicarlo. Ahora, la pestaña Evaluate integra conjuntos de pruebas de respuesta única y conversacionales, graders automáticos, pruebas de seguridad y un panel de Review que señala bloqueos antes del despliegue. Incluso la creación de estas baterías de evaluación se puede impulsar de forma agéntica usando el servidor MCP desde Cowork o GitHub Copilot.
La lección práctica de la demo: por qué un «100 %» puede engañarte
Uno de los momentos más instructivos de la sesión llegó en la demostración en vivo de Alice Appleton con un agente de asesoramiento financiero (Financial Insights Agent v8), conectado al servidor MCP de Morningstar, a un flujo de consulta al CRM y a un flujo determinista de aprobación previa antes de enviar correos a clientes.
Al comparar el mismo conjunto de evaluación sobre distintos modelos en la pestaña Evaluate, los resultados mostraron diferencias de coste abismales:
- GPT Astra: 207 créditos por ejecución (~2 $), con una duración de 2 minutos y 6 segundos.
- GPT 5.1 Sol: alrededor de 0,50 $ por ejecución.
- GPT 5.1 Terra: 49 créditos por ejecución (~0,40 $), 1 minuto y 22 segundos de media y una puntuación del 100 % en General quality.
La tentación obvia ante esa comparativa sería elegir inmediatamente el modelo cinco veces más barato. Pero Alice demostró exactamente el peligro contrario: cuando solo aplicas un evaluador genérico como General quality (relevancia y completitud), modelos muy distintos pueden empatar en nota superficial aunque difieran en rigor analítico, uso correcto de herramientas o adherencia a la política de inversión de la empresa.
Por eso el trabajo real de ingeniería de evaluaciones consiste en abrir las trazas, revisar cualitativamente la respuesta y la cadena de pensamiento (Chain of thought), y diseñar una batería de graders exigentes que reflejen el negocio:
- General quality: relevancia y completitud básicas.
- Task completion: criterios explícitos que comprueban si se cumplió el objetivo real del caso de uso.
- Capability use / Tool success: verificación de que el agente invocó las herramientas y servidores MCP esperados en lugar de improvisar datos.
- Content safety: detección sistemática de riesgos de seguridad y contenido inapropiado.
- Clasificadores personalizados: reglas propias para auditar tono, cumplimiento regulatorio o restricciones específicas del dominio.
Qué aporta la visión de Anthropic y el Eval-Driven Development
El planteamiento de Microsoft encaja casi al milímetro con las prácticas que equipos líderes de IA han consolidado durante 2026. En su guía de ingeniería Demystifying evals for AI agents, Anthropic subraya tres principios que cualquier arquitecto de Copilot Studio debería incorporar:
- Evaluar trayectorias, no solo la respuesta final: en agentes multipaso con herramientas, dos respuestas aparentemente válidas pueden esconder comportamientos muy distintos. Hay que medir si el agente eligió el conector adecuado en el paso correcto, si gestionó bien un fallo temporal y si evitó bucles innecesarios que disparan el consumo de créditos.
- Combinar tres tipos de evaluadores: graders deterministas (comprobaciones objetivas de estado, formato o invocación de herramientas), evaluadores basados en modelo (LLM-as-a-Judge, flexibles pero que deben calibrarse periódicamente frente al criterio humano) y revisión humana en los casos más sensibles.
- Cuidar la cola de errores, no solo la media: un 95 % de acierto medio puede ocultar un 5 % de fallos inaceptables —como enviar un correo sin aprobación o citar cifras inventadas a un cliente—. En entornos corporativos, la ingeniería de evaluaciones sirve sobre todo para cerrar esa cola de riesgo.
El 1 % antes de publicar, el 99 % en producción: Monitor y FinOps
Jason Moore remató su exposición sobre evaluaciones con una advertencia cargada de experiencia operativa: los problemas que detectas antes de publicar representan apenas el 1 % de los desafíos. La deriva de calidad (quality drift), los cambios en APIs externas, los timeouts y los picos inesperados de gasto aparecen una vez que el agente entra en producción.
Para cerrar ese ciclo completo, Copilot Studio incorpora dos piezas complementarias junto a la gobernanza global de Agent 365 y Microsoft Purview:
- Pestaña Monitor (Preview): centraliza sesiones, usuarios activos, duración media, tasa de resolución, consumo estimado de créditos, fallos contra servicios externos y valoraciones de usuarios finales (pulgar arriba/abajo con comentarios). Además, todos estos datos de monitorización pueden consultarse de forma conversacional desde Cowork para recibir diagnósticos y recomendaciones concretas.
- FinOps for Agents (GA): responde a una preocupación creciente en los departamentos financieros. Permite ver qué agentes y qué usuarios impulsan el gasto de créditos, establecer presupuestos y límites en cascada, y prever el consumo antes de desplegar un nuevo agente a toda la organización.
Cinco pasos prácticos para equipos de Power Platform y Dynamics 365
Si trabajas diseñando o gobernando agentes en Copilot Studio, el mensaje de Ignite 2026 se traduce en acciones muy concretas que puedes aplicar desde hoy:
- Diseña arquitecturas híbridas, no «todo agente»: reserva el razonamiento del agente para lo ambiguo y delega aprobaciones, consultas repetitivas al CRM o envíos críticos en workflows deterministas. Ganarás velocidad, fiabilidad y menor consumo de créditos.
- Construye un conjunto de pruebas «dorado» de 20 a 50 casos reales: evita llenar tu suite con cientos de preguntas sintéticas genéricas. Prioriza escenarios reales de negocio, casos límite y errores que ya hayas visto ocurrir.
- No te fíes de un único indicador de calidad: combina General quality con Task completion, verificación de uso de herramientas/MCP y clasificadores propios, y audita manualmente las trazas y la cadena de pensamiento cuando compares modelos.
- Mide coste por resultado, no solo precio por token: haz pruebas comparativas entre modelos (y entre el Standard harness y el Microsoft Copilot Harness) evaluando juntos tasa de éxito, latencia y créditos consumidos.
- Convierte cada incidente en producción en una prueba de regresión: conecta el flujo entre Monitor y Evaluate para que cualquier queja de un usuario o caída de calidad pase a formar parte permanente de tus pruebas antes de la siguiente publicación.
Conclusión
Que Microsoft haya reconstruido Copilot Studio íntegramente con agentes que construyen agentes no significa que sobren los ingenieros ni los arquitectos de Power Platform. Significa que el valor técnico ha cambiado de lugar. Cuando generar código, flujos y configuraciones pasa a ser rápido y abundante, la diferencia entre un prototipo vistoso y un sistema empresarial fiable depende de algo menos espectacular pero infinitamente más decisivo: la disciplina de evaluar, medir y gobernar cada decisión que toman tus agentes.
Fuentes
- Microsoft Events (Microsoft Ignite 2026) — Sesión What's new in Copilot Studio (Jason Moore y Alice Appleton)
- Microsoft Learn — Evaluación de agentes en Microsoft Copilot Studio
- Microsoft Learn — Agent harnesses en Microsoft Copilot Studio
- Anthropic — Demystifying evals for AI agents (enero 2026)
- Simon Willison's Weblog — How StrongDM's AI team build serious software without even looking at the code (febrero 2026)

Aún no hay comentarios. Sé el primero en comentar.